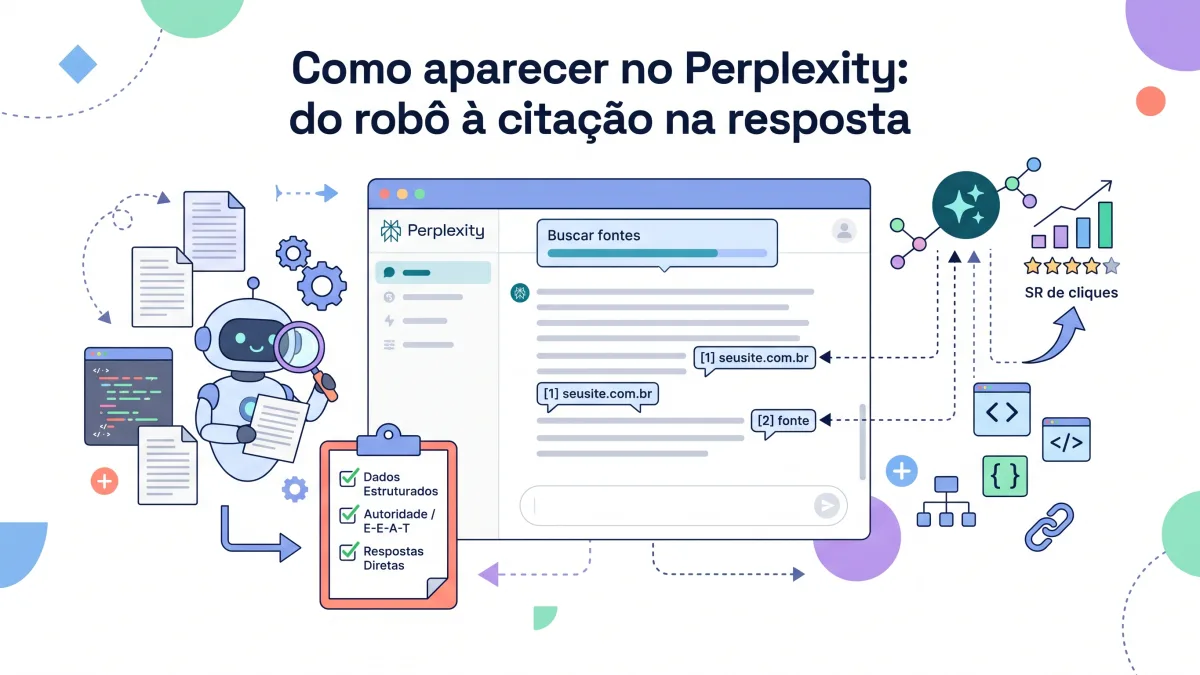
O Perplexity é um buscador com IA que responde por escrito e numera, ao longo do texto, as páginas de onde tirou cada informação. Aparecer nele é ter o seu site entre essas fontes, e não existe inscrição nem formulário para isso. O que existe é uma sequência de três portas, e o site pode ficar parado em qualquer uma delas: o robô da Perplexity precisa conseguir entrar, a página precisa ir para o índice da empresa e um trecho seu precisa ganhar dos trechos de outros sites na hora da pergunta. O texto percorre as três, apoiado no que a Perplexity documenta e no que medimos em sites brasileiros.
De onde o Perplexity tira as páginas que cita?
De um índice próprio, montado pelo PerplexityBot, e de leituras feitas no momento da pergunta. A central de ajuda descreve o serviço como uma busca na internet em tempo real, e cada resposta traz citações numeradas com link para a fonte original.
Os detalhes do índice estão num artigo técnico que a empresa publicou em 25 de setembro de 2025, quando lançou a sua API de busca. Ali a Perplexity conta que:
- o índice acompanha mais de 200 bilhões de URLs, e a mesma infraestrutura atende 200 milhões de buscas por dia;
- um modelo de aprendizado de máquina decide quais endereços entram e quando cada um volta a ser lido, pesando a importância da página e o quanto ela costuma mudar;
- na hora da pergunta, a busca combina correspondência de palavras com busca por sentido, descarta o que não responde ou está velho e reordena o que sobrou em várias etapas;
- a pontuação também é feita em pedaços da página, e não só no documento inteiro, para que o modelo receba apenas o trecho útil.
Vários guias em português afirmam que o Perplexity roda em cima do índice do Bing. Não achamos nada publicado pela Perplexity que confirme isso; o que ela descreve é uma estrutura de rastreamento e indexação dela mesma. É a diferença mais importante em relação ao roteiro para virar fonte do ChatGPT, cuja busca, segundo a OpenAI, se apoia em provedores de terceiros. No Perplexity, quem lê o seu site para montar o índice é o robô da própria empresa, e é para ele que a porta precisa estar aberta.
Quais robôs da Perplexity visitam o seu site?
São dois, com funções e regras diferentes. A página de robôs da documentação da Perplexity, que consultamos em 27 de outubro de 2026, descreve cada um assim:
| PerplexityBot | Perplexity-User | |
|---|---|---|
| Para que serve | Encontrar sites e linkar para eles nos resultados de busca do Perplexity | Abrir uma página quando alguém faz uma pergunta e a resposta precisa dela |
| Segue o robots.txt | Sim. A empresa recomenda liberá-lo para o site aparecer nos resultados | Em geral, não. Como o pedido parte de uma pessoa, a documentação avisa que ele costuma ignorar as regras do arquivo |
| Coleta para treinar modelos | Não, segundo a documentação | Não, segundo a documentação |
| Lista oficial de IPs | perplexitybot.json |
perplexity-user.json |
Para quem quer ser citado, a leitura da tabela é simples. Sem o PerplexityBot, a página não entra no índice que alimenta os resultados. Sem o Perplexity-User, o Perplexity não consegue abrir a página no instante em que monta a resposta. Os dois se identificam no user-agent como PerplexityBot/1.0 e Perplexity-User/1.0, com um link para a documentação no fim. Uma mudança no robots.txt, diz a empresa, pode levar até 24 horas para ser percebida.
Um alerta sobre o que circula na própria página de resultados: um dos guias mais bem colocados nessa busca garante que os dois robôs obedecem ao robots.txt. A documentação diz o contrário para o Perplexity-User. Quem quer impedir essa leitura precisa de uma regra no servidor.
Como liberar o PerplexityBot no robots.txt?
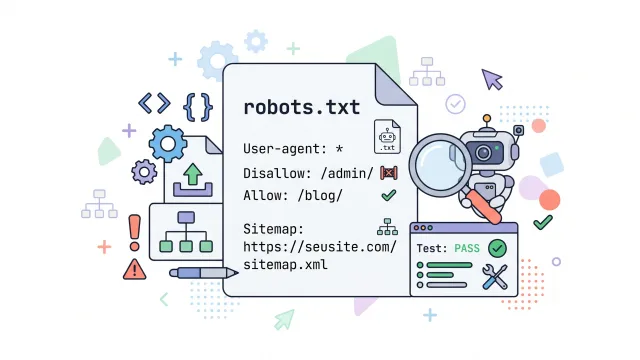
Na maioria dos sites não há nada a escrever: sem uma regra que o barre, ele entra. O trabalho é achar o bloqueio que alguém deixou para trás. No navegador, digite o seu domínio seguido de /robots.txt e procure três padrões.
- Um grupo com o nome dele e
Disallow: /logo abaixo:
User-agent: PerplexityBot
Disallow: /
- Uma sequência de linhas
User-agentcom robôs de IA barrados de uma vez, em que o PerplexityBot aparece misturado aos robôs de treinamento. Acontece muito quando alguém copia uma lista pronta para recusar treinamento e leva junto um robô de busca. User-agent: *seguido deDisallow: /, que fecha o site para todos os robôs, inclusive ele.
Nos dois primeiros casos, apague a linha User-agent: PerplexityBot ou o grupo inteiro. No terceiro, o estrago vai além do Perplexity; confira se não foi publicado o arquivo do ambiente de testes. Depois rode o domínio na ferramenta que confere o arquivo para cada robô de IA e veja o que vale para cada nome. A escolha sobre os outros robôs, de treinamento e de outras empresas, tem um texto só dela: o mapa de robôs de IA, com o que cada empresa usa para buscar e para treinar.
Por que o firewall barra o Perplexity com o robots.txt liberado?
Porque o arquivo é só um aviso que o robô consulta, e o firewall decide antes disso. Regras de proteção contra robôs, na CDN, na hospedagem ou num plugin de segurança, recusam a visita pelo nome que vem no user-agent, sem consultar o arquivo. O dono do site confere o robots.txt, vê tudo liberado e não entende por que nunca é citado.
Fomos ver quanto isso pesa no Brasil. Separamos o comportamento do PerplexityBot nas análises que o Nota do Site rodou em 53 endereços .br nos dias 20, 21 e 22 do mesmo outubro, sem identificar nenhum:
- 3 barram o robô no robots.txt;
- 6 recusam a requisição no servidor, 5 deles com o arquivo liberado;
- 1 aparece nas duas listas;
- somando sem repetir, 8 dos 53 deixam o PerplexityBot de fora.
O bloqueio no servidor, portanto, aparece com o dobro da frequência do bloqueio no arquivo. E quase nunca é dirigido à Perplexity: nesses sites, o ChatGPT-User e o Claude-User costumam ser recusados junto. É o retrato de uma opção genérica do tipo "bloquear robôs de IA", ligada no painel da CDN ou do firewall, que leva os robôs de busca de carona.
Uma ressalva de método. O validador repete a requisição com o user-agent de cada robô e compara a resposta com a que um navegador comum recebe, só que a partir dos nossos servidores, e não dos IPs da Perplexity. Um firewall que confere o IP pode recusar o nosso teste e aceitar o robô verdadeiro. Trate o resultado como motivo para abrir os registros do servidor, como mostramos mais abaixo.
Para corrigir, a documentação da Perplexity sugere uma regra de liberação que exija duas condições ao mesmo tempo:
- o user-agent contém
PerplexityBotouPerplexity-User; - o IP de origem está nas faixas publicadas em
perplexitybot.jsoneperplexity-user.json.
A ação da regra é permitir, e ela precisa ficar acima das regras de bloqueio, para ser avaliada primeiro. Exigir o IP junto com o nome tem motivo: qualquer programa pode se apresentar como PerplexityBot. A página traz o roteiro para a Cloudflare e para a AWS WAF e recomenda atualizar as faixas de forma automática, porque a lista muda. Quando baixamos os dois arquivos, em 27 de outubro de 2026, o do PerplexityBot tinha 8 faixas e o do Perplexity-User tinha 4. Se o site passa pela Cloudflare, a parte sobre robôs de IA no guia de configuração da Cloudflare conta o que mudou no padrão de domínios novos em 2026.
O que a Cloudflare e a Perplexity discutiram em agosto de 2025?
Em 4 de agosto de 2025, a Cloudflare relatou um teste com domínios novos que proibiam qualquer robô no robots.txt e barravam no firewall os dois robôs declarados da Perplexity. Mesmo assim, segundo ela, o Perplexity respondia com detalhes do conteúdo, e os acessos vinham também de um user-agent genérico de Chrome no macOS, a partir de IPs fora da lista oficial. A Cloudflare tirou a Perplexity da sua lista de robôs verificados e incluiu esse padrão na regra gerenciada contra robôs de IA, disponível até no plano grátis.
No mesmo dia, a Perplexity respondeu no blog dela. Disse que as visitas eram feitas a pedido de usuários, e não rastreamento, e que os 3 a 6 milhões de requisições diárias atribuídas a ela vinham do BrowserBase, um serviço de navegador em nuvem de terceiros que a empresa afirma usar só em tarefas específicas, com menos de 45 mil requisições por dia.
Não cabe a este guia decidir quem tem razão. Para quem administra um site, sobram duas consequências práticas:
- Se a sua CDN oferece "liberar robôs verificados", não conte com o PerplexityBot dentro dessa opção. Confira a lista no painel ou crie a regra por nome e IP descrita acima.
- Se a ideia é o contrário, impedir o Perplexity de ler o site, o robots.txt resolve para o PerplexityBot, mas não para o Perplexity-User. Pela documentação, a barreira para ele precisa estar no firewall.
O que faz um trecho seu ser escolhido como fonte?
A Perplexity não publica uma lista de fatores de ranqueamento. O artigo técnico, porém, mostra o que o sistema faz com cada página, e cada etapa sugere um cuidado concreto:
| O que o sistema faz | O que isso pede da sua página |
|---|---|
| Divide o documento em trechos que se sustentam sozinhos e pontua cada um | Seções que respondem a uma pergunta sem depender do parágrafo anterior, com a resposta logo abaixo do subtítulo |
| Procura por palavra exata e por sentido ao mesmo tempo | O termo que o seu cliente digita, escrito por extenso, e não só o jargão da empresa |
| Descarta na pré-filtragem o que não responde ou está velho | Data de atualização verdadeira e revisão quando o assunto muda |
| Usa regras próprias para extrair listas e tabelas | Tabela feita como tabela no HTML, e não como imagem ou como colunas alinhadas com espaços |
| Dá prioridade, no armazenamento do índice, a páginas de domínios com autoridade e de assuntos pouco cobertos | Um dado, um teste ou um caso que só você tem, num tema em que a web ainda responde mal |
Um exemplo. Uma vidraçaria de Curitiba cuja página de box para banheiro diz só "peça seu orçamento" não tem o que oferecer a quem pergunta ao Perplexity quanto tempo leva para instalar um box de vidro temperado. Com o prazo médio por modelo, o que costuma atrasar (a medição, o vidro feito sob medida) e a data da revisão, a mesma página vira um trecho que cabe inteiro na resposta.
Antes de qualquer ajuste de texto, confira se o conteúdo está no HTML que o servidor entrega. A documentação da Perplexity não diz se os robôs dela executam JavaScript, e o levantamento da Vercel com a MERJ, de dezembro de 2024, não encontrou execução de scripts por eles; os detalhes estão no texto sobre sites montados no navegador que chegam vazios aos robôs. O nosso simulador de leitura por robô de IA mostra o texto que chega sem os scripts.
A documentação dos robôs da Perplexity não menciona dados estruturados nem llms.txt. Ter os dois não atrapalha, só não espere deles o efeito que alguns guias prometem, quase sempre com porcentagens sem origem.
Como saber se o Perplexity já cita o seu site?
Cada fonte responde a uma pergunta diferente, então vale olhar as três.
Na própria ferramenta. Faça as perguntas do jeito que o seu cliente escreveria, com cidade e detalhe ("quanto tempo demora para instalar box de vidro em Curitiba"), e abra as fontes de cada resposta. Repita em dias diferentes e anote quando o seu domínio aparece e com qual página.
No GA4. No relatório de aquisição de tráfego, mude a dimensão principal para a origem da sessão e filtre por perplexity. Não conte só com o canal padrão Assistente de IA: o Perplexity não aparece entre os exemplos que o Google dá para ele, e não encontramos na documentação da Perplexity nenhum parâmetro de campanha acrescentado aos links. O método para juntar as visitas de todos os assistentes num grupo de canais resolve isso.
Nos registros do servidor. É o único lugar que mostra o robô, e não só a pessoa. Num servidor Nginx ou Apache com o log no formato padrão, estes comandos contam os códigos de resposta que cada robô recebeu:
grep "PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c
grep "Perplexity-User" access.log | awk '{print $9}' | sort | uniq -c
Como ler o resultado:
- Muitos 200 para o PerplexityBot: o robô percorre o site e alimenta o índice.
- 403 ou 503: o firewall está recusando, ainda que o robots.txt libere.
- Visitas do Perplexity-User: alguém fez uma pergunta e a resposta precisou da sua página naquele momento. É o sinal mais próximo de uma citação que o log consegue dar.
Para confirmar que um IP é mesmo da Perplexity, compare com a lista publicada. Com Python 3 instalado, troque o IP do fim pelo que apareceu no seu log:
python3 -c "import ipaddress,json,urllib.request,sys; ip=ipaddress.ip_address(sys.argv[1]); d=json.load(urllib.request.urlopen('https://www.perplexity.ai/perplexitybot.json')); print(any(ip in ipaddress.ip_network(p['ipv4Prefix']) for p in d['prefixes'] if 'ipv4Prefix' in p))" 18.97.1.229
True quer dizer que o endereço está na lista. False quer dizer que alguém está usando o nome do robô. Para o Perplexity-User, troque o arquivo por perplexity-user.json.
Qual a ordem de conferência antes de mexer no texto?
A ordem conta, porque texto bom não adianta com a porta fechada.
- Abra o robots.txt e procure
PerplexityBot, listas de robôs de IA barrados em bloco eDisallow: /no grupo geral. - Passe o domínio pela análise gratuita do Nota do Site: ela mostra se o PerplexityBot e o Perplexity-User recebem a página ou um erro do servidor, e se o texto principal está no HTML.
- Se o bloqueio estiver no servidor, peça a quem cuida da CDN ou da hospedagem a regra de liberação por nome e IP, posicionada acima das regras de bloqueio.
- Com o acesso resolvido, escolha as páginas que tiram as dúvidas que mais chegam pelo WhatsApp e revise cada seção para que ela se explique sozinha.
Duas semanas depois, repita as perguntas no Perplexity e procure o Perplexity-User nos registros do servidor. Se ele aparece, o seu site já está sendo aberto na hora das respostas.