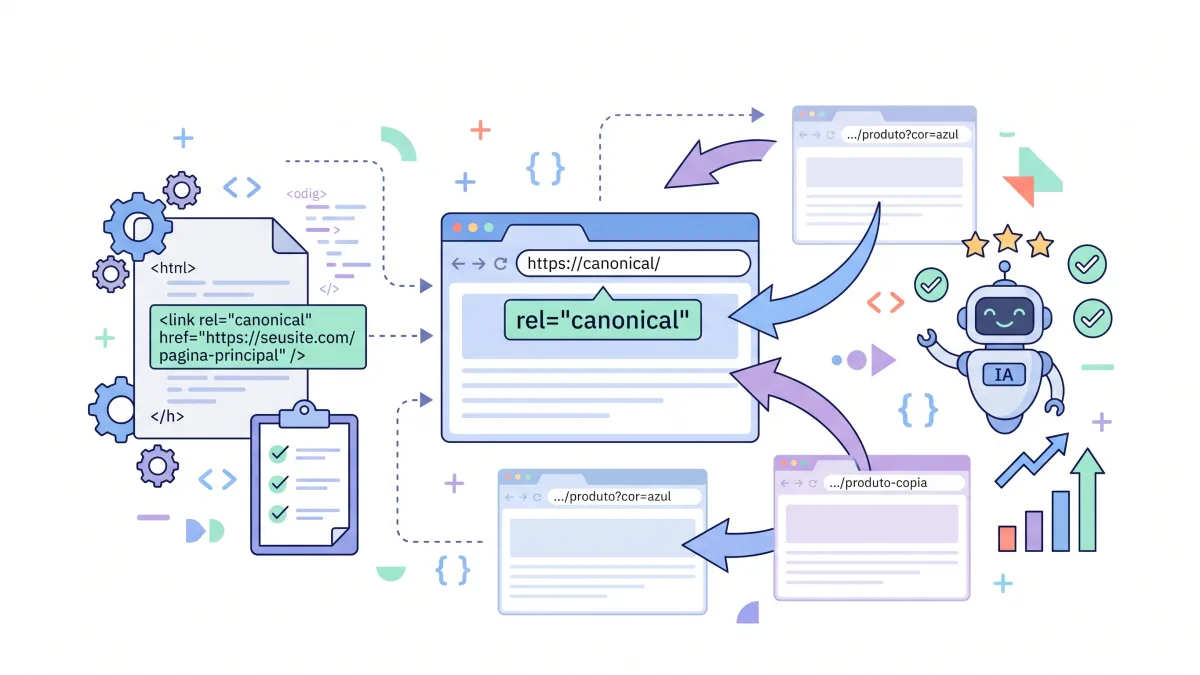
A tag canonical é a linha do código que diz ao Google qual é o endereço oficial de uma página quando o mesmo conteúdo abre em mais de um endereço. Ela fica no <head> do HTML e o Google a lê como uma sugestão forte, não como uma ordem:
<link rel="canonical" href="https://www.suaempresa.com.br/servicos/dedetizacao">
Quase todo site precisa dela, porque quase todo site cria cópias sem perceber: o link da bio do Instagram com ?utm_source, a categoria da loja reordenada por preço, a versão sem www que ninguém redirecionou. Aqui você vê de onde vêm essas cópias num site brasileiro comum, qual ferramenta resolve cada uma (canonical, 301, noindex ou nada) e os erros que levam o Google a desprezar o canonical que você declarou.
O que é a tag canonical e o que ela faz?
É um aviso ao buscador: entre as versões parecidas desta página, mostre esta. O nome vem da RFC 6596, de abril de 2012, que define a relação "canonical" como a versão preferida pelo autor de um conteúdo. O Google chama de canonização o trabalho de escolher um endereço representativo para um grupo de páginas iguais e exibir só ele nos resultados.
Quando aceita o seu canonical, o Google:
- exibe o endereço escolhido, e não a cópia com parâmetro (o exemplo da própria documentação é o
?gclid=, que o Google Ads acrescenta aos links dos anúncios); - junta na versão oficial os sinais que as cópias recebem, como links;
- rastreia a canônica com mais frequência e as cópias com menos, o que sobra de tempo do robô para páginas novas.
Três regras de escrita valem para qualquer site. A tag mora no <head>; dentro do <body>, o Google a desconsidera. O endereço vai completo, com https:// e domínio: caminho relativo é aceito, mas o Google não recomenda, porque ele pode acabar levando um ambiente de testes a ser rastreado. E a página oficial aponta para si mesma, o chamado canonical autorreferente. Parece redundante, mas é ele que protege a página quando alguém chega por um link com parâmetro.
Antes de seguir, um alívio: repetir conteúdo dentro do próprio site não fere as políticas de spam do Google. O prejuízo é outro. Sem indicação sua, ele escolhe sozinho qual versão vai aparecer, e a escolhida pode ser a feia, com parâmetro, ou a que você nem queria no ar.
De onde vêm as páginas duplicadas num site comum?
Quase nunca de alguém copiando texto. Elas nascem do jeito como o site monta os endereços. Estes são os casos que mais aparecem em site de empresa e em loja virtual:
- Parâmetros de campanha. O link do e-mail marketing chega com
?utm_source=newsletter&utm_medium=email. Para o servidor, é outro endereço com a mesma página. - Ordenação e filtros da loja.
/camisetas?ordem=menor-preco,/camisetas?cor=preta&tamanho=g. Cada combinação é um endereço novo, e uma categoria com meia dúzia de filtros gera centenas deles. - http, https, com e sem www. Quatro portas para a mesma casa quando nenhuma leva às outras.
- Barra no fim. O Google trata
/contatoe/contato/como endereços diferentes. A exceção é a raiz:https://suaempresa.com.brehttps://suaempresa.com.br/são o mesmo endereço. - Versão para impressão. Portais e blogs antigos ainda oferecem
/imprimir/ou?print=1com o texto inteiro. - Produto em mais de uma categoria. Quando o endereço segue o caminho da navegação, o mesmo tênis vive em
/masculino/tenis-corrida-xe em/promocao/tenis-corrida-x. - Variantes.
/tenis-corrida-x?cor=azule?cor=preto, com descrição idêntica. - Ambiente de testes aberto. O
homolog.suaempresa.com.brque ficou acessível e foi parar no índice. A documentação do Google cita esse caso como variante acidental.
Canonical, 301 ou noindex: qual resolve cada tipo de cópia?
Decida por uma pergunta: a cópia precisa continuar abrindo para quem visita? Se não precisa, redirecione com 301. Se precisa, mas não deve disputar a busca, use canonical. Se a página não tem nada a fazer no Google, noindex. E se o Google já agrupou do jeito certo, deixe como está.
| Caso | O que usar | Por quê |
|---|---|---|
?utm_, ?gclid= e outros parâmetros de campanha |
Canonical da página para o endereço sem parâmetro | O link da campanha precisa funcionar, e a medição depende do parâmetro |
Categoria reordenada (?ordem=menor-preco) |
Canonical para a categoria sem parâmetro | É a mesma lista em outra ordem |
| Milhares de combinações de filtro | Bloqueio do padrão no robots.txt | É o que o Google recomenda para navegação facetada; o canonical só reduz o rastreamento aos poucos |
Filtro com procura própria (/sofas/retratil-3-lugares) |
Canonical para si mesmo, como página normal | Tem busca, título e texto próprios |
| Variante de cor ou tamanho por parâmetro | Canonical para o produto sem parâmetro | Recomendação do Google para lojas |
| http, versão sem www, barra no fim | 301 | Ninguém precisa da versão descartada aberta |
| Versão para impressão | Canonical para a página normal | Quem imprime continua usando |
| Mesmo produto em duas categorias | Canonical para um endereço fixo do produto, com os links internos apontando para ele | Os dois caminhos seguem navegáveis |
| Páginas 2, 3 e 4 de uma categoria | Canonical de cada uma para ela mesma | Não são cópias da página 1 |
| Busca interna, carrinho, login, página de obrigado | Noindex | Não servem a quem vem da busca |
| Versões em outro idioma | hreflang, e cada versão com canonical próprio | Conteúdo traduzido não conta como cópia |
| Página que o Search Console já mostra como "alternativa com tag canônica adequada" | Nada | O Google entendeu a sua escolha |
Duas linhas pedem cuidado. Bloquear um endereço no robots.txt impede o Google de ler a página, e aí ele também não lê o canonical nem o noindex dela. Não misture as duas coisas: filtro bloqueado dispensa canonical, e página com noindex precisa estar liberada para leitura. A outra: não use noindex para escolher a versão oficial entre duas páginas iguais. O Google avisa que o noindex tira a página da busca por completo e indica o canonical para esse trabalho.
Para configurar esse 301 no servidor, siga o guia sobre como forçar o https com redirecionamento.
Como o Google decide qual versão é a oficial?
Ele soma sinais, e o canonical é um deles. A documentação classifica a força de cada método assim:
| Sinal | Força |
|---|---|
| Redirecionamento permanente (301 ou 308) | Forte |
<link rel="canonical"> no HTML |
Forte |
Cabeçalho HTTP Link com rel="canonical", útil para PDF |
Forte |
| Constar no sitemap | Fraco |
Pesam também a preferência pelo https, quando o certificado não tem problema, os links internos e a semelhança real entre as páginas. Os sinais se acumulam, e o Google diz que combinar métodos aumenta a chance de a sua escolha prevalecer, desde que todos apontem para o mesmo endereço. Só não declare o canonical no HTML e no cabeçalho HTTP ao mesmo tempo: a própria documentação diz que isso abre espaço para erro e pede para escolher um dos dois.
Quando os sinais discordam, a decisão volta para o Google. O sitemap lista http://, o canonical diz https://, o menu linka a versão com barra: cada peça vota num endereço. É por isso que ele trata a sua preferência como uma dica, e não como uma regra.
Como colocar o canonical no WordPress, no Wix, na Shopify e em site próprio?
Na maioria das plataformas, ele já vem ligado. O trabalho é conferir se está certo e saber onde mexer quando precisar.
- WordPress. Desde a versão 2.9, o próprio WordPress imprime um canonical autorreferente em posts e páginas, pela função
rel_canonical. Em listas de categoria, tag e na página de posts, o WordPress puro não imprime nada, e quem preenche essa falta é o plugin de SEO. No Yoast, o campo fica na seção Avançado do Yoast, dentro do editor de cada post ou página, e pede o endereço completo. Página marcada com noindex sai sem canonical no Yoast, de propósito. - Wix. Cria um canonical autorreferente em todas as páginas. Para trocar, abra Páginas e menu, clique em Mais ações ao lado da página, vá em SEO básico, depois em SEO avançado e Tags adicionais, e edite a tag canonical. A ajuda do Wix avisa que mudar o canonical padrão pode tirar a página do sitemap.
- Shopify. O canonical sai do tema. O arquivo
theme.liquidtraz<link rel="canonical" href="{{ canonical_url }}">dentro do<head>, e a plataforma preenche o endereço. Trocou de tema ou alguém editou o código? Confira se a linha continua lá. - Outras plataformas de loja. Procure o campo nas configurações de SEO do produto e da categoria. Se não existir, o canonical vem do tema, e quem altera é o suporte da plataforma ou o desenvolvedor do tema.
- Site próprio. Gere a tag no servidor, a partir do endereço oficial guardado no banco de dados, e não do endereço que o visitante digitou. O deslize que mais vemos é o código montar o canonical com a URL da requisição, parâmetros incluídos: cada
?utm_vira canônica de si mesma, e a tag deixa de servir para alguma coisa.
Por que o Google ignora o canonical?
Porque ele contradiz outro sinal ou foi escrito de um jeito que o Google não aceita. Num post de 2013 da equipe de indexação, que segue no ar, e na documentação atual, aparecem estes casos:
- Duas tags canonical com endereços diferentes. Acontece quando o tema e o plugin de SEO imprimem cada um a sua. Nesse caso, o Google provavelmente ignora todas, e o benefício que a tag certa traria se perde. No nosso validador, isso é falha.
- Tag fora do
<head>. No corpo da página ela não vale. O Google recomenda pôr a tag o mais cedo possível no<head>e conferir se o cabeçalho é HTML válido, porque um elemento fora do lugar pode encerrar o<head>antes de a tag aparecer. - Destino que não serve. A página indicada precisa existir, responder sem erro e poder ser indexada. Apontar para um 404, um soft 404 ou uma página com noindex anula o pedido.
- Canonical herdado de um modelo. O tema comprado vem com o canonical do site do autor, ou um campo preenchido uma vez se repete em todas as páginas. O Google cita o primeiro caso. Quando o endereço repetido é o da página inicial, o pedido equivale a dizer que o site inteiro é cópia da home.
- Página 2 apontando para a página 1. A segunda página da categoria tem produtos que a primeira não mostra. Não é cópia, e o Google pede um canonical próprio para cada página da sequência.
- Páginas que não são iguais. Canonical de uma categoria para o artigo em destaque nela, ou de um produto para outro parecido. O Google orienta conferir se a maior parte do texto principal da cópia também está na canônica. Se não estiver, a indicação tende a ser desconsiderada.
- Sinais que brigam. Canonical para a versão com www, sitemap com a versão sem, links do menu para uma terceira.
Canonical colocado por JavaScript funciona?
No Google, funciona com condições. A documentação diz que o melhor lugar para o canonical é o HTML. Se o HTML já traz a tag, o JavaScript pode repetir o mesmo valor, mas não trocar por outro. Se não houver como manter os dois iguais, deixe o canonical fora do HTML e coloque só pelo script, garantindo que a página termine com uma tag só.
O caso que mais complica é o site montado no navegador, em que o HTML inicial traz o canonical da página inicial para todas as rotas e o script corrige depois. O Google recebe dois recados diferentes. E ferramentas que leem o HTML sem executar script, como o nosso validador, ficam só com o primeiro. Sites feitos com React, Vue ou geradores por IA caem nisso com frequência, como mostramos no texto sobre o site feito no Lovable que não aparece no Google. Para conferir o seu, use o código-fonte (Ctrl+U). A ferramenta de inspecionar do navegador exibe o resultado depois do script, e aqui o que importa é o antes.
Títulos e descrições repetidos: cópia ou modelo mal configurado?
Na maioria das vezes, modelo. O title repetido é a pista mais rápida de página duplicada, mas a conclusão depende do que vem junto. Se duas páginas têm o mesmo title, a mesma descrição e o mesmo texto, são cópias e pedem canonical ou 301. Se só o title e a descrição se repetem, o problema está no tema ou no plugin, que carimba o mesmo texto em tudo. O Google inclui o título repetido num grupo de páginas entre os motivos que o levam a reescrever o título exibido no resultado.
O retrato que achamos: em 26 dos 53 sites havia páginas internas bastantes para comparar. O título repetido apareceu em 5 deles (19%). Em 3, era um par de páginas; nos outros 2, grupos de 5 e de 7 páginas com o mesmo título. A descrição repetida apareceu em 8 (31%), e em 4 deles o mesmo texto cobria de 6 a 8 páginas. O validador acusa falha quando mais de 30% das páginas lidas dividem o texto com outra, e alerta abaixo disso.
Para corrigir:
- Pegue a lista de páginas com o mesmo title. O validador mostra os grupos, com os endereços de cada um.
- Abra duas delas lado a lado. Conteúdo igual: escolha a oficial e aponte o canonical ou redirecione a outra. Conteúdo diferente: ajuste o modelo para puxar o nome do produto, do serviço ou do post.
- Reescreva à mão o title e a descrição das páginas que mais recebem visitas, com a fórmula para title e descrição que ganham o clique.
Quantos sites brasileiros erram o canonical?
Um em cada quatro (26%), contando só a página inicial. No fim de outubro de 2026, olhamos o canonical da home de 53 sites com domínio .br. Em 8, a tag apontava para outro endereço. Em 6, ela não existia. São 14 sites em que a porta de entrada do site não diz com clareza qual é o próprio endereço. Numa página inicial quase não há motivo legítimo para o canonical mandar para outro lugar, e as causas prováveis são as da seção sobre erros: tema copiado, versão http ou sem www esquecida no campo, endereço de testes.
O endereço do domínio também ajuda a explicar. Em 7 de 52 sites, a outra versão (com ou sem www, ou http) abria separada, sem redirecionar, o que faz cada página existir em pelo menos dois endereços. Em outros 5, o redirecionamento existia, mas com código temporário.
Fizemos o teste no nosso próprio blog. Um post aberto com ?utm_source=whatsapp&utm_campaign=teste carrega normalmente e traz no código o canonical sem os parâmetros. O mesmo post com barra no fim e pela versão sem www responde com 301 para o endereço oficial. É a combinação da tabela lá de cima: canonical para o que precisa continuar abrindo, redirecionamento para o que não precisa.
Como saber qual endereço o Google escolheu?
Pela Inspeção de URL do Search Console. Cole o endereço e compare dois campos: "URL canônico declarado pelo usuário", que é o seu, e "URL canônico selecionado pelo Google". Quando batem, a sua escolha valeu. Quando não batem, o Google agrupou a página com outra e ficou com o endereço do segundo campo.
Antes de brigar, faça a pergunta que o próprio Google sugere: a escolha dele faz mais sentido para quem busca? Às vezes faz. A versão que ele preferiu recebe os links do menu, está no sitemap e é a que as pessoas compartilham. Nesse caso, mude o seu canonical. Se a sua escolha é a certa, alinhe os sinais da seção sobre como o Google decide e dê tempo: a documentação diz que as páginas podem continuar agrupadas por até duas semanas depois da correção.
No relatório Indexação > Páginas, essas situações aparecem como "Cópia sem página canônica selecionada pelo usuário" e "Cópia, o Google e o usuário não escolheram a mesma página canônica". O significado de cada status de cópia e como pedir a validação estão no guia de indexação, onde também contamos por que o nosso domínio apareceu sem www no dia da estreia, com 301, canonical e sitemap já certos.
Um roteiro de 20 minutos para revisar o canonical do seu site
- Abra o código-fonte (Ctrl+U) de três páginas: a inicial, uma de serviço ou categoria e um post ou produto. Procure
rel="canonical". Deve haver uma tag só, no<head>, com o endereço completo da própria página. - Abra uma delas com
?utm_source=testeno fim do endereço e veja se o canonical continua limpo, sem o parâmetro. - Digite o domínio nas quatro versões (http e https, com e sem www) e uma página interna com e sem barra no fim. Tudo precisa terminar no mesmo endereço.
- Se for loja, abra uma categoria filtrada e outra reordenada e veja para onde aponta o canonical de cada uma.
- Passe a página inicial na Inspeção de URL e compare o canonical declarado com o selecionado.
Os passos 1 e 3, e ainda a busca por títulos e descrições repetidos entre as páginas, saem de uma vez na análise grátis do Nota do Site.