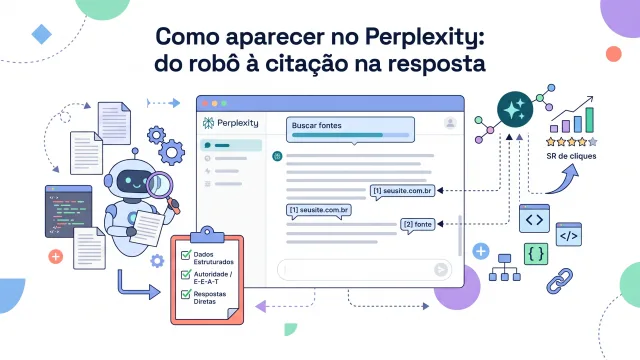
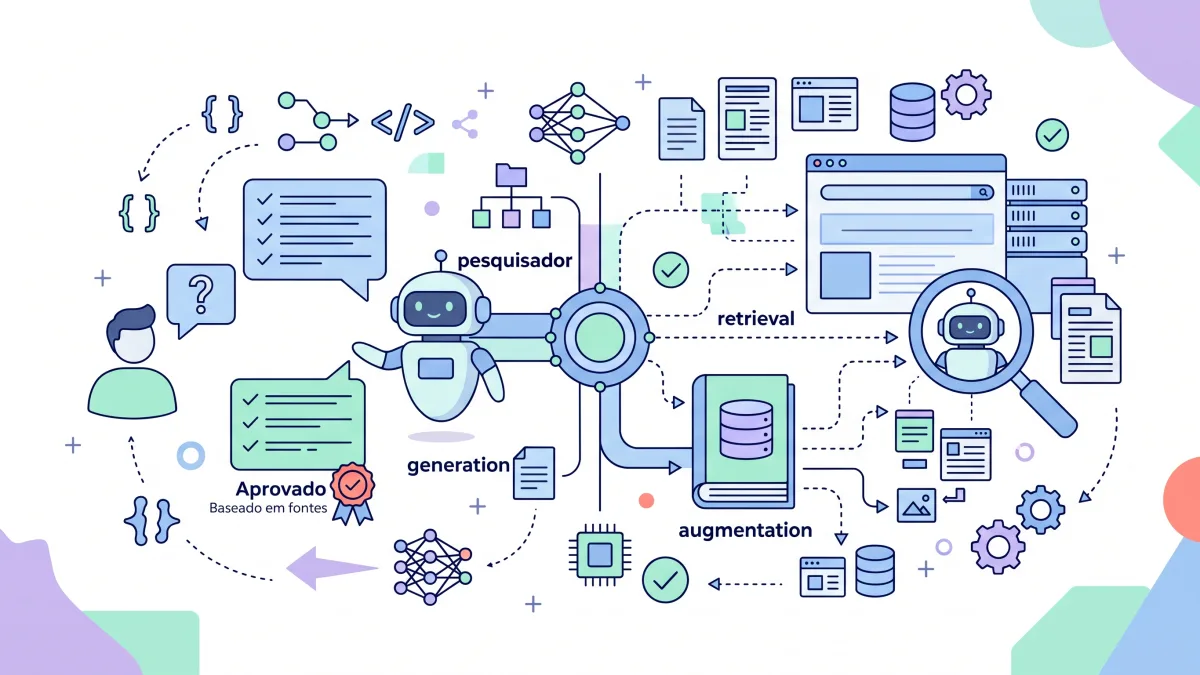
Quando você pergunta ao ChatGPT o horário de uma farmácia no feriado e ele responde com um link embaixo, alguma coisa aconteceu entre a pergunta e o texto: a IA foi atrás de páginas, separou pedaços delas e escreveu a resposta em cima desses pedaços. Esse método tem nome, RAG, e entender cada etapa dele ajuda a enxergar por que um site aparece como fonte e outro, com o mesmo assunto, fica de fora.
O que é RAG, em uma frase?
RAG é a técnica em que um modelo de IA consulta uma fonte de texto antes de responder e usa os trechos encontrados como base da resposta. A sigla vem do inglês retrieval-augmented generation, traduzida como geração aumentada por recuperação: "recuperação" é a busca dos trechos, e "geração" é o texto que o modelo escreve.
Sem essa consulta, o modelo de linguagem responde só com o que absorveu no treino, que tem data para acabar. É como uma prova sem consulta. Com RAG, a prova passa a ter material ao lado, e esse material pode ser a web inteira, o índice de um buscador ou a pasta de documentos de uma empresa. A qualidade da resposta passa a depender muito do que está nesse material, e é aí que entra o seu site.
De onde veio o termo RAG?
De um artigo científico publicado em maio de 2020 por 12 pesquisadores do Facebook AI Research, da University College London e da Universidade de Nova York, com Patrick Lewis como primeiro autor. O título é "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", e o trabalho foi aceito na NeurIPS 2020, uma das principais conferências de aprendizado de máquina.
A Wikipédia em inglês de dezembro de 2018 foi cortada em pedaços de 100 palavras, cerca de 21 milhões deles. Um buscador treinado escolhia os pedaços mais próximos da pergunta, e um gerador de texto escrevia a resposta a partir deles. Três resultados do artigo explicam por que a ideia pegou:
- Perguntas abertas: o sistema alcançou o melhor resultado publicado até então em três conjuntos de teste de perguntas e respostas (Natural Questions, WebQuestions e CuratedTrec).
- Texto mais fiel aos fatos: numa avaliação feita por pessoas com 452 pares de textos gerados, o RAG foi considerado mais factual em 42,7% dos casos, contra 7,1% do modelo sem busca.
- Atualização sem retreino: os autores trocaram o índice de 2018 por um de 2016 e perguntaram pelos ocupantes de 82 cargos de líderes mundiais que trocaram de mãos entre 2016 e 2018. Com o índice de 2018, o sistema acertou 68% dos líderes de 2018; com o índice de 2016, acertou só 4% deles.
O terceiro ponto é o que mais interessa a quem tem site. O modelo era o mesmo nos dois testes; mudou apenas o que ele tinha para ler. Num sistema de RAG, o que a IA diz sobre o seu negócio depende da versão da sua página que está no índice que ela consulta.
Como o RAG funciona, etapa por etapa?
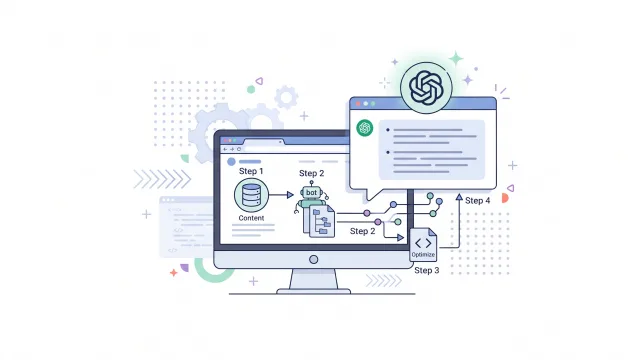
Cada empresa monta o seu sistema de um jeito, mas a documentação da OpenAI, da Anthropic, do Google e da Microsoft descreve uma sequência parecida:
- Decidir se vale buscar. O modelo avalia a pergunta. A documentação da ferramenta de busca do Claude diz que ele busca quando a resposta depende de informação atual, que muda ou que está fora do treino (preços, notícias, dados de uma empresa) e responde direto quando o assunto é estável, como uma conta ou um conceito de ciência.
- Transformar a pergunta em consultas. A pergunta do usuário quase nunca vai inteira para o buscador. A Microsoft explica que o Copilot gera uma consulta de poucas palavras a partir do pedido e a envia ao Bing. O Google descreve, na Visão geral criada por IA e no Modo IA, a técnica de query fan-out: disparar várias buscas relacionadas, sobre subtemas da pergunta, ao mesmo tempo.
- Cortar as páginas em trechos. As páginas encontradas viram pedaços menores. A Anthropic fala em algumas centenas de tokens (cada token é um fragmento de palavra) por pedaço, o equivalente a poucos parágrafos.
- Comparar pelo significado. Cada trecho é convertido num embedding, uma lista de números que representa o sentido do texto. A OpenAI define assim: a distância entre duas dessas listas mede o quanto os textos se relacionam. É o que faz "conserto de geladeira" encontrar uma página que fala em "assistência técnica de refrigerador". Muitos sistemas somam a isso a busca por palavra exata, que acerta nomes de produto e códigos que o significado sozinho deixa passar.
- Montar o contexto. Os trechos mais bem pontuados vão junto com a pergunta para o modelo. Nos testes publicados pela Anthropic, entregar os 20 melhores trechos funcionou melhor do que entregar 5 ou 10.
- Escrever e citar. O modelo redige a resposta e aponta de onde tirou cada parte. Na API do Claude, cada citação traz o endereço da página e até 150 caracteres do texto citado. Na API da OpenAI, cada link citado vem amarrado ao pedaço exato da resposta que ele sustenta.
O detalhe que mais pesa para quem tem site: o modelo nunca lê a página do jeito que um visitante lê. Ele recebe alguns pedaços soltos, escolhidos por semelhança com a pergunta, misturados com pedaços de outros sites.
RAG é o que faz ChatGPT, Perplexity, Gemini e Copilot citarem fontes?
É, sempre que eles buscam antes de responder. A documentação de cada um descreve a sua versão do processo:
| Ferramenta | Onde busca | O que a documentação oficial diz |
|---|---|---|
| ChatGPT | Páginas que o OAI-SearchBot leu | O OAI-SearchBot é usado para mostrar sites nos resultados de busca do ChatGPT; quem o bloqueia sai dessas respostas |
| Perplexity | Índice próprio e leituras na hora | Segundo a central de ajuda, ele pesquisa a web no momento da pergunta e numera as fontes ao longo da resposta |
| Gemini | Pesquisa Google | Na API, o modelo decide se a busca melhora a resposta, gera uma ou mais consultas e devolve o texto com citações (página atualizada em 28/10/2026) |
| Copilot | Bing | O Copilot manda ao Bing uma consulta gerada a partir do pedido, usa o retorno para compor a resposta e lista as citações com link abaixo do texto (documentos da Microsoft de 18/08/2026) |
| Visão geral criada por IA | Índice do Google | Vira link de apoio quem já foi indexado e tem permissão para mostrar snippet; o Google diz que não há exigência técnica adicional |
Quando a ferramenta não busca, ela responde com o que aprendeu no treino e não tem link para mostrar. Por isso a mesma pergunta às vezes vem com fontes e às vezes sem.
O caminho prático para cada uma está nos textos próprios: o roteiro para ser citado no ChatGPT, o do índice próprio da Perplexity e do PerplexityBot e o do Gemini, que depende do índice da Pesquisa Google.
Onde o RAG aparece fora da busca na web?
Nas empresas. Um assistente que responde dúvidas de clientes com base no manual do produto, na tabela de preços e na política de trocas é um RAG: as mesmas etapas, só que a fonte é uma pasta de documentos internos em vez da web.
A vantagem sobre treinar um modelo com esses dados é a mesma do artigo de 2020. Mudou o preço, troca-se o documento, e o assistente passa a responder certo sem novo treino. O ajuste fino (fine-tuning, um treino extra do modelo) muda o jeito de o modelo escrever; o RAG muda o que ele tem para ler.
Buscar antes diminui as respostas inventadas, mas não acaba com elas: o modelo ainda pode juntar mal dois trechos ou se apoiar num documento velho. Quem monta um assistente desses aprende rápido que PDF desatualizado vira resposta desatualizada.
O que o RAG muda para o seu site?
Muda o que significa "estar bem posicionado". Para virar fonte de uma resposta, a página precisa passar por três filtros, nesta ordem.
Ser encontrada: no índice e com o robô de busca liberado
O RAG só recupera o que está no índice que a ferramenta consulta. Para o Copilot é o Bing, para o Gemini e a Visão geral é o Google, para o Perplexity é o índice da própria empresa, e no ChatGPT a entrada documentada é o OAI-SearchBot. Uma página fora desses índices não chega nem à etapa 3.
Dois bloqueios aparecem com frequência. O primeiro é o robots.txt que barra os robôs de busca das IAs junto com os de treinamento; a diferença entre o robô que busca para responder e o que coleta para treinar decide o que pode ser fechado sem perder citação. O segundo é o noindex esquecido. O validador encontrou essa marcação em 12 de 302 páginas lidas entre 20 e 22/10/2026, numa base de 53 sites brasileiros; elas estavam em 6 sites.
Ser lida: o texto precisa vir no HTML
O robô que busca a página para o RAG costuma ler só o HTML que o servidor manda. Em dezembro de 2024, a Vercel publicou, junto com a consultoria MERJ, uma medição em que nenhum dos grandes robôs de IA rodava JavaScript: nem os da OpenAI, nem o ClaudeBot, nem o PerplexityBot. A exceção era o Gemini, que se apoia na infraestrutura do Google. Conteúdo que depende de script para surgir na tela, para esses robôs, não existe, e não há o que cortar em trechos. O simulador de leitura sem JavaScript mostra o que sobra da sua página nessas condições.
Ser citável: cada trecho precisa se explicar sozinho
Aqui está o ponto que quase nenhum guia sobre RAG traz para o lado de quem escreve. Como o sistema corta a página, o trecho escolhido chega ao modelo sem o resto do texto. A Anthropic mostrou o problema com um exemplo: um trecho dizia apenas que "a receita da empresa cresceu 3% em relação ao trimestre anterior", sem dizer que empresa nem que trimestre. Solto, esse pedaço não serve para responder nada.
A solução da Anthropic foi acrescentar, por programa, uma frase de contexto a cada trecho antes de indexar. Nos testes dela, as falhas de recuperação caíram 35% com isso, 49% quando somado à busca por palavra exata e 67% com uma etapa extra de reordenação. Você não controla o sistema de cada IA, mas controla o texto. Escrever cada seção já com o contexto é fazer, à mão, o que esse método faz por programa.
Na prática:
- Responda na primeira frase da seção. O subtítulo pergunta, a frase seguinte responde, e o detalhe vem depois.
- Diga o nome das coisas. Produto, serviço, cidade, data e preço escritos por extenso, em vez de "nosso plano", "lá" ou "este valor".
- Corte as pontes para trás. "Como vimos acima" e "este ponto se relaciona ao anterior" não fazem sentido num trecho isolado.
- Ponha data no que muda. Preço e horário com o mês da última revisão.
Um exemplo. Um pet shop de Recife tem, na página de serviços, uma seção "Quanto custa?" que começa com "Depende do porte, como explicamos acima". Recortado, o trecho não diz de que serviço, de que loja nem de que cidade se trata. Reescrito como "O banho de cachorro de porte pequeno no pet shop, em Recife, custa R$ 70 em outubro de 2026, com secagem e corte de unhas incluídos", ele responde sozinho a quem pergunta quanto custa dar banho no cachorro em Recife.
Como estavam 10 páginas de empresas brasileiras?
Em geral com texto bom, mas duas barram a leitura logo na entrada e quatro das seis com pergunta no título demoram a responder. Lemos em 29/10/2026 dez páginas de empresas brasileiras que respondem a dúvidas comuns de cliente: quanto custa abrir uma empresa, a limpeza da caixa-d'água, a escolha da bancada da cozinha, a vacina do cachorro, o entupimento da pia, o preço da energia solar e os BTUs do ar-condicionado. A leitura foi feita como a de um robô de busca, sem executar JavaScript, respeitando o robots.txt e com uma página por site. A amostra é pequena e serve como retrato, não como estatística do mercado.
| O que conferimos | Resultado |
|---|---|
| Páginas que recusaram a leitura com erro 403 | 2 de 10 |
| Páginas com o texto principal no HTML, entre as que abriram | 8 de 8 |
| Robots.txt que fecha as páginas ao OAI-SearchBot e ao PerplexityBot | 1 de 8 |
| Título em forma de pergunta com a resposta antes do primeiro subtítulo | 2 de 6 |
| Páginas com seção que remete à parte anterior já no primeiro parágrafo | 2 de 8 |
Três achados chamam atenção. As duas recusas vieram da proteção da CDN, que barrou um robô desconhecido antes de qualquer regra do robots.txt; quando esse tipo de barreira pega um robô de busca de IA, a página some das respostas sem que o dono perceba.
O bloqueio no robots.txt estava numa das páginas mais bem escritas da amostra, com o custo logo na primeira frase. O arquivo deixava os robôs de busca da OpenAI e da Perplexity abrir só o llms.txt e alguns arquivos parecidos, e fechava todo o resto do site. O texto pronto para ser citado ficou fora do alcance das duas ferramentas.
Nas páginas com título em forma de pergunta, a maioria adiava a resposta: abria com "a resposta tem duas partes", "não existe um valor único" ou "vamos falar sobre isso neste artigo", e o número ou o veredito só aparecia mais adiante. Para um sistema que recorta trechos, isso traz o risco de o pedaço escolhido ser justamente o que não responde.
Que trecho do seu site uma IA conseguiria citar hoje?
Faça o teste com a página que mais recebe perguntas de cliente.
- Abra a conferência do robots.txt por robô de IA e confirme que OAI-SearchBot, Claude-SearchBot e PerplexityBot podem ler a página.
- Passe o endereço no simulador de leitura sem JavaScript e veja se o texto principal aparece inteiro.
- Liste as cinco perguntas que mais chegam pelo WhatsApp ou pelo telefone. Para cada uma, ache a seção da página que responde e leia só a primeira frase dela, como se fosse o único pedaço que a IA recebeu. Se ela não disser o quê, onde, quanto e desde quando, reescreva.
- Coloque o domínio no validador para ver numa só tela o acesso dos robôs, o texto sem JavaScript, a resposta no começo da página e os dados que deixam o conteúdo citável.
Depois de publicar a mudança, faça as mesmas perguntas ao ChatGPT, ao Perplexity e ao Copilot em dias diferentes e anote quais páginas aparecem nas fontes. É a forma mais direta de ver o seu texto passando pelas seis etapas.